Частые вопросы.
Если нужного здесь нет, напишите нам — info@krino.uk.
Где он работает и куда уходят данные?
Где работает Krino?
В вашей собственной инфраструктуре. Он поставляется контейнерами и поднимается рядом с PostgreSQL и NATS на ваших серверах или в вашем облачном аккаунте. Поддержка при внедрении входит в лицензию.
Данные правда никуда не уходят?
Не уходят. Сигналы обогащения — поставщики одноразовых адресов, диапазоны IP дата-центров, данные о стране и операторе, санкционные списки — читаются из списков внутри вашей инфраструктуры. Наружу не идёт ни один запрос на транзакцию. Единственный исходящий трафик — периодическое обновление списков, которое забирает список и не несёт ничего о том, какой клиент с чем совпал.
Единственное исключение, если вы его включите, — ИИ-ассистент: ваш вопрос и те строки, которые модель читает для ответа, уходят выбранному вами провайдеру. По умолчанию он выключен, провайдера и ключ указываете вы, а если наружу не должно уходить вообще ничего, его можно направить на модель, которую вы держите сами.
Единственное исключение, если вы его включите, — ИИ-ассистент: ваш вопрос и те строки, которые модель читает для ответа, уходят выбранному вами провайдеру. По умолчанию он выключен, провайдера и ключ указываете вы, а если наружу не должно уходить вообще ничего, его можно направить на модель, которую вы держите сами.
Сколько баз данных придётся держать?
Одну: PostgreSQL. Решения, кейсы, правила и настройки лежат в общей схеме; данные событий, которые загружает каждая организация, — в своей отдельной. Обе несёт одна и та же база.
Отдельную аналитическую базу рядом мы не ставим, потому что вопрос velocity-правила не аналитический: «сколько раз эта карта использовалась за последние 24 часа» — это не сканирование миллионов строк, а узкий срез по одному клиенту. Его обслуживают частичные индексы по актуальным строкам — и эти индексы выводятся из опубликованных правил сами: опубликуйте новое velocity-правило, и нужный ему индекс придёт вместе с ним.
Отдельную аналитическую базу рядом мы не ставим, потому что вопрос velocity-правила не аналитический: «сколько раз эта карта использовалась за последние 24 часа» — это не сканирование миллионов строк, а узкий срез по одному клиенту. Его обслуживают частичные индексы по актуальным строкам — и эти индексы выводятся из опубликованных правил сами: опубликуйте новое velocity-правило, и нужный ему индекс придёт вместе с ним.
Нужно ли переносить данные?
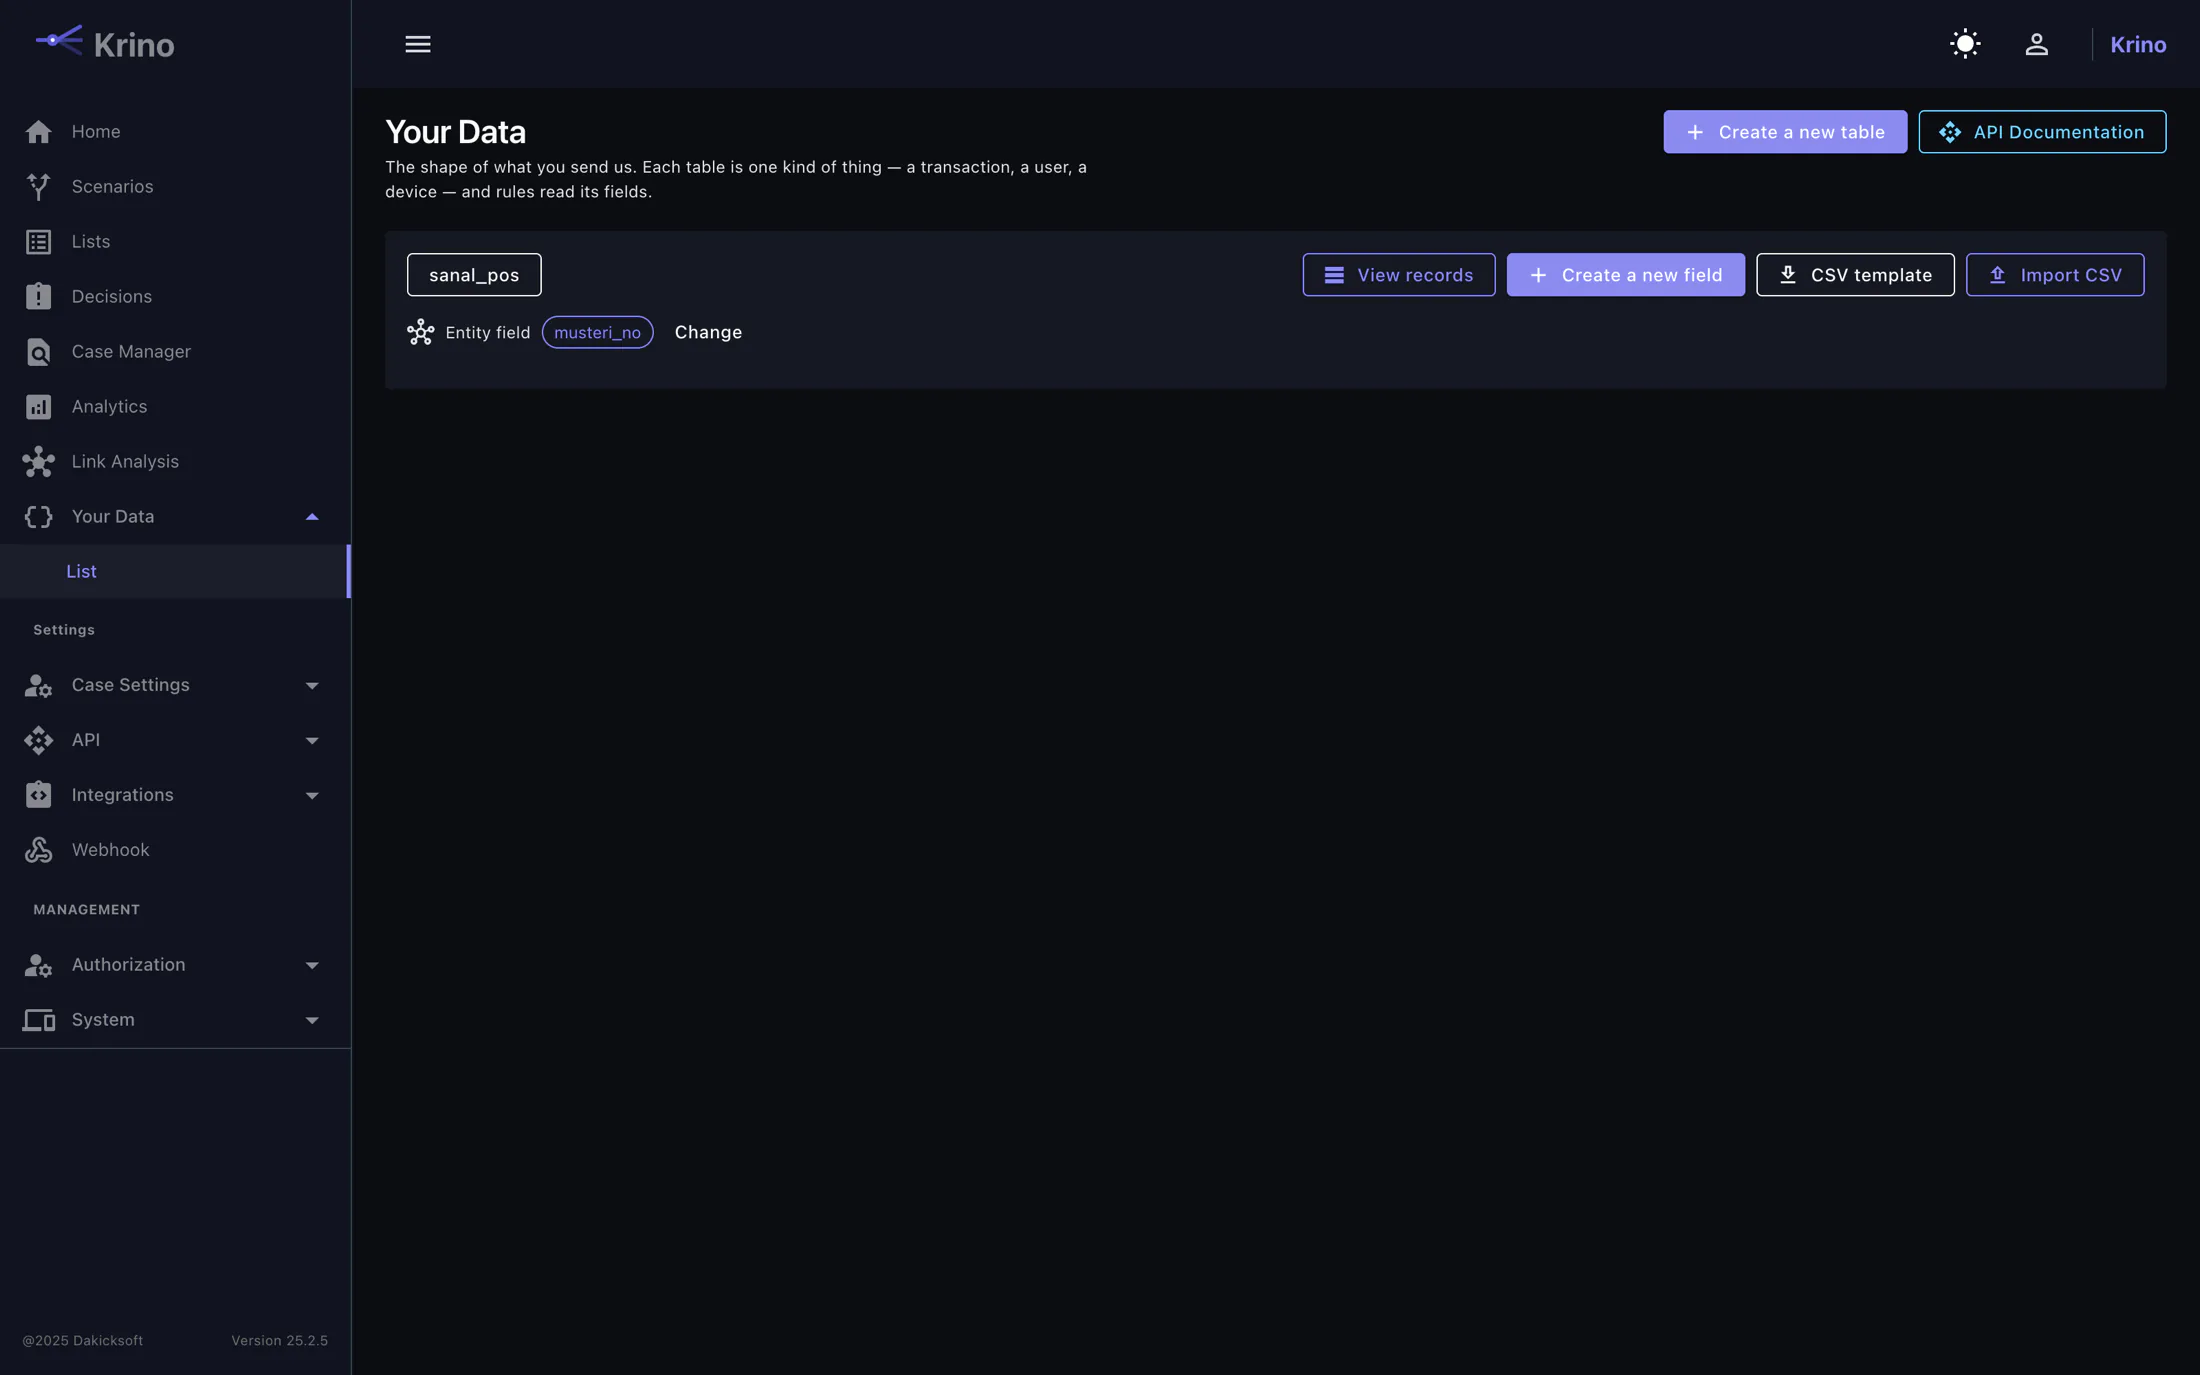
Нет. Вы описываете в Krino свою собственную модель данных и отправляете события как есть. Имена полей остаются такими, как вы их назвали; переводить их в чужую схему не нужно.
Как он подключается к моей системе?
Сколько времени занимает интеграция?
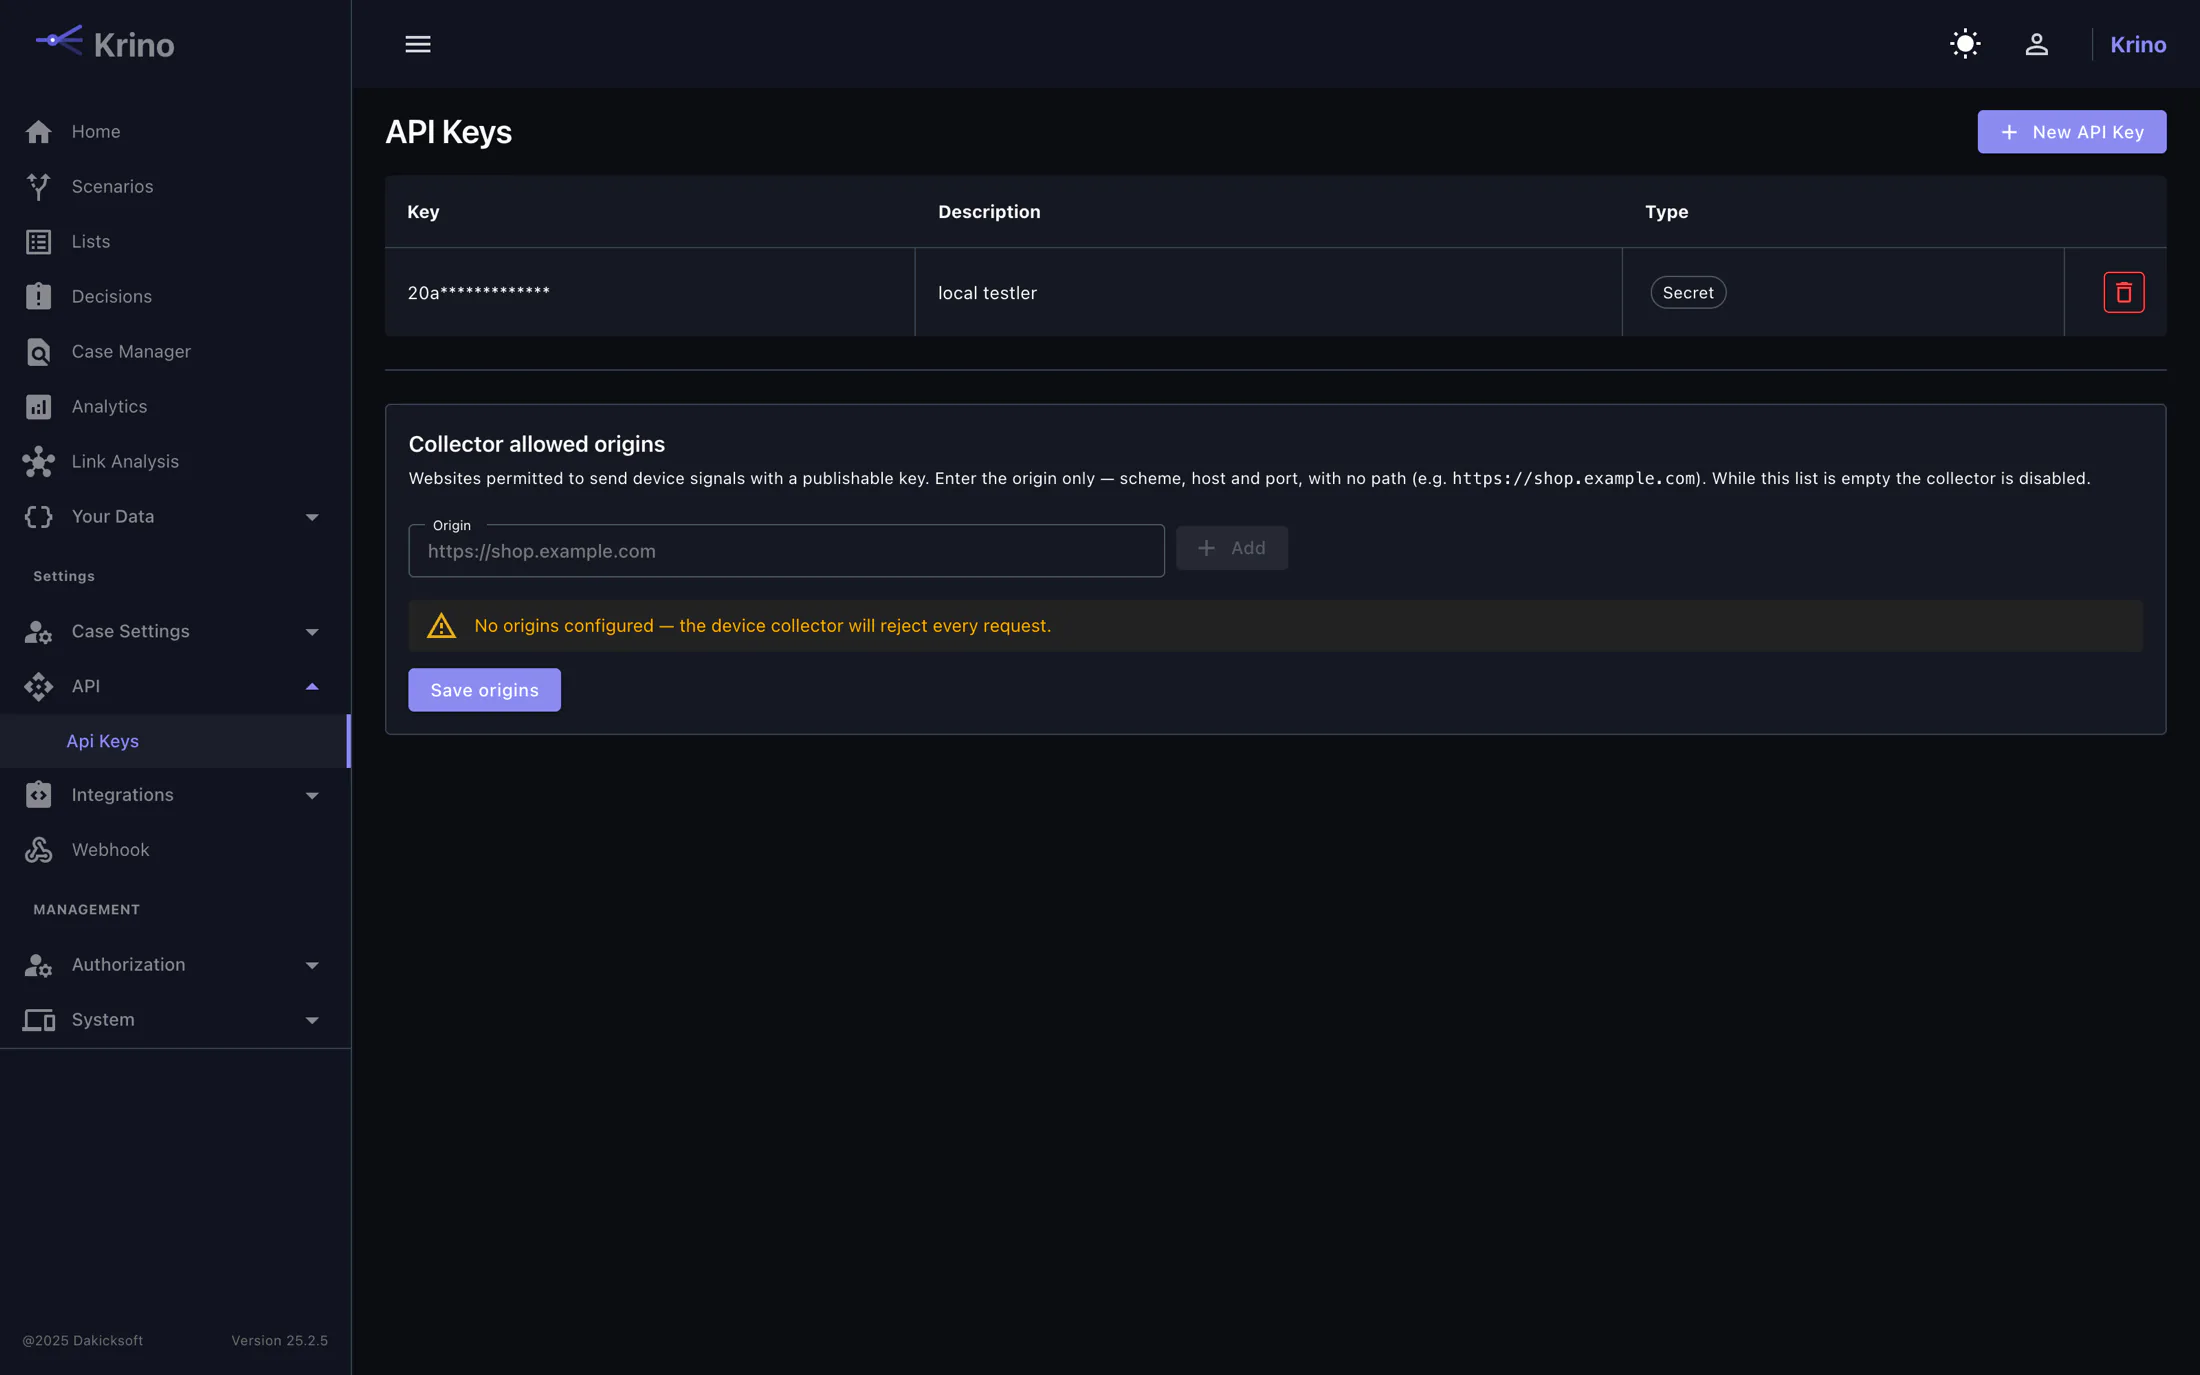
Технически это две точки: POST /api/ingestion/{type}, куда вы отправляете события, и POST /api/decisions, где запрашиваете решение. Аутентификация — заголовок X-API-KEY. Хватит и половины дня; настоящее время уходит на то, чтобы выверить правила.
Сколько занимает одно решение?
Десятки миллисекунд в типичном сценарии. Поскольку обогащение офлайн, внешнего ожидания нет; на число влияют количество правил и ширина velocity-окон. Каждый ответ сообщает, сколько миллисекунд заняло это решение; запросите детализацию по правилам — и он скажет, куда ушло это время: чтение данных, подсчёт velocity-окон, выполнение правил. Когда интеграция замедляется, искать подросший шаг не нужно, ответ сам об этом говорит. Дашборд даёт перцентиль, а перцентиль нельзя спросить об одной транзакции.
А если я не хочу ждать решения?
Отправляйте события отдельно и получайте исход подписанным webhook'ом. Webhooks следуют формату Standard Webhooks с HMAC-SHA256 — проверка подписи занимает несколько строк.
Можно загружать данные пакетом?
Да. Есть точки для одной записи, для множества записей и для CSV. Загрузить историю и прогнать по ней свои правила — самый быстрый способ проверить всё до запуска.
Повседневная работа.
Нужен ли разработчик, чтобы писать правила?
Нет. Правило — это дерево условий, которое собирается на экране: выберите поле, задайте сравнение, поставьте баллы. Разработчики нужны только на первичную интеграцию.
Как снизить число ложных срабатываний?
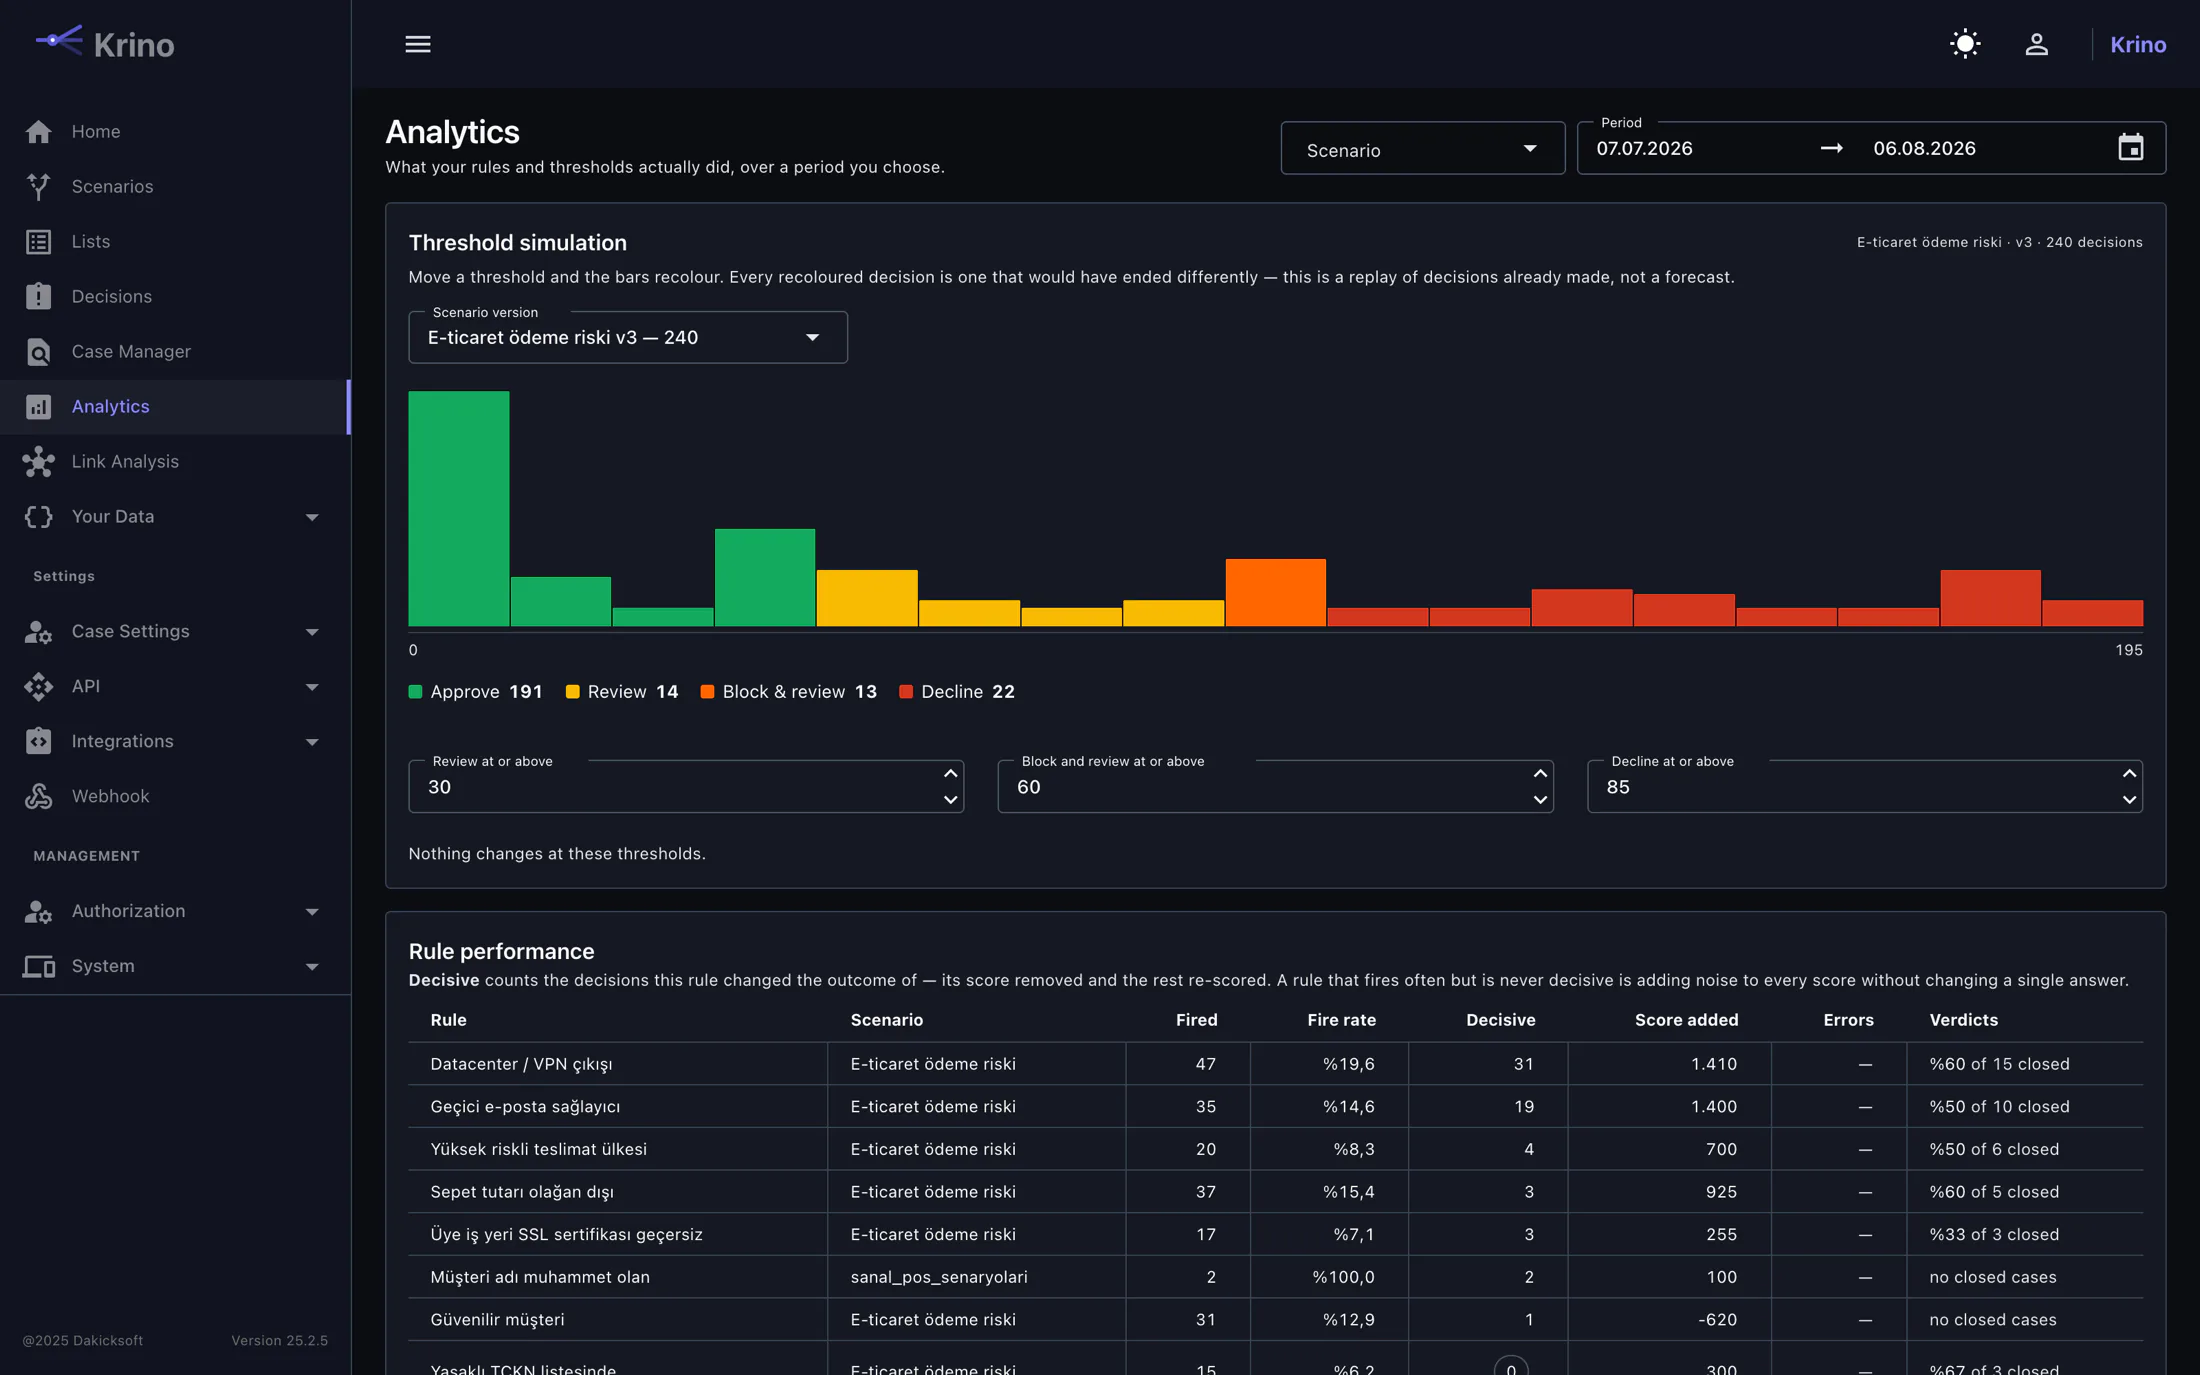
Экран аналитики показывает, как часто срабатывало каждое правило и как часто оно реально меняло исход. Правило, которое срабатывает постоянно, но никогда не решает дело, просто добавляет шум в каждый балл. На том же экране можно сдвинуть порог и увидеть, как легли бы прошлые решения.
Можно проверить новое правило до запуска?
Тремя способами. Заполните шаблон таблицы своими записями и загрузите его, чтобы увидеть исход по каждой строке. Прогоните черновую версию теневым прогоном на живом трафике — она ни на что не влияет, но перечисляет каждую транзакцию, где разошлась с рабочей версией. Или прогоните правило прямо по реальным транзакциям прошлого месяца: по закрытым кейсам, ответ по которым вы уже знаете, где каждая запись оценивается по состоянию на момент поступления. Это даёт ответ без ожидания месяца и ничего не записывает — ни решений, ни кейсов, ни оповещений.
Можно ли потом посмотреть старые решения?
Да. Каждое решение сохраняется со значениями полей того момента и баллами сработавших правил. Откройте его через месяцы — и увидите картину того дня, даже если правило с тех пор изменилось.
Как показать, что изменилось в правилах за прошлый месяц?
Вы кладёте две версии рядом: добавленные, удалённые и изменённые правила, «до» и «после» по каждому полю, пороги и условие триггера. Условия правил показываются фразами, а не в JSON — два блока JSON рядом дают сравнение, которое никто не читает. А на вопрос «кто это согласовал» отвечает разделение публикации на два шага: один просит, другой проверяет и публикует, и автор запроса не может согласовать его сам.
Что делает ИИ-ассистент и какую модель он использует?
Две вещи: отвечает на вопросы о решениях, правилах и кейсах обычным языком и превращает тот же вопрос в таблицу с графиком. Модель выбираете вы — OpenAI, Anthropic, Google Gemini или любая точка, совместимая с OpenAI, включая модель на ваших собственных серверах. Ключ ваш, и счёт тоже ваш; никакого встроенного в продукт аккаунта нет. Подробности: ИИ-ассистент.
Может ли ассистент закрыть кейс?
Нет. У него нет прав на запись: он не может закрыть кейс, опубликовать набор правил или изменить настройку. Читает он собственные записи платформы — решения, срабатывания правил и кейсы; таблиц событий, которые вы присылаете, в этом списке нет. Каждая реплика при этом записывается: вопрос, ответ, прочитанные источники, модель и израсходованные токены.
Можно ли смотреть решения в момент их принятия?
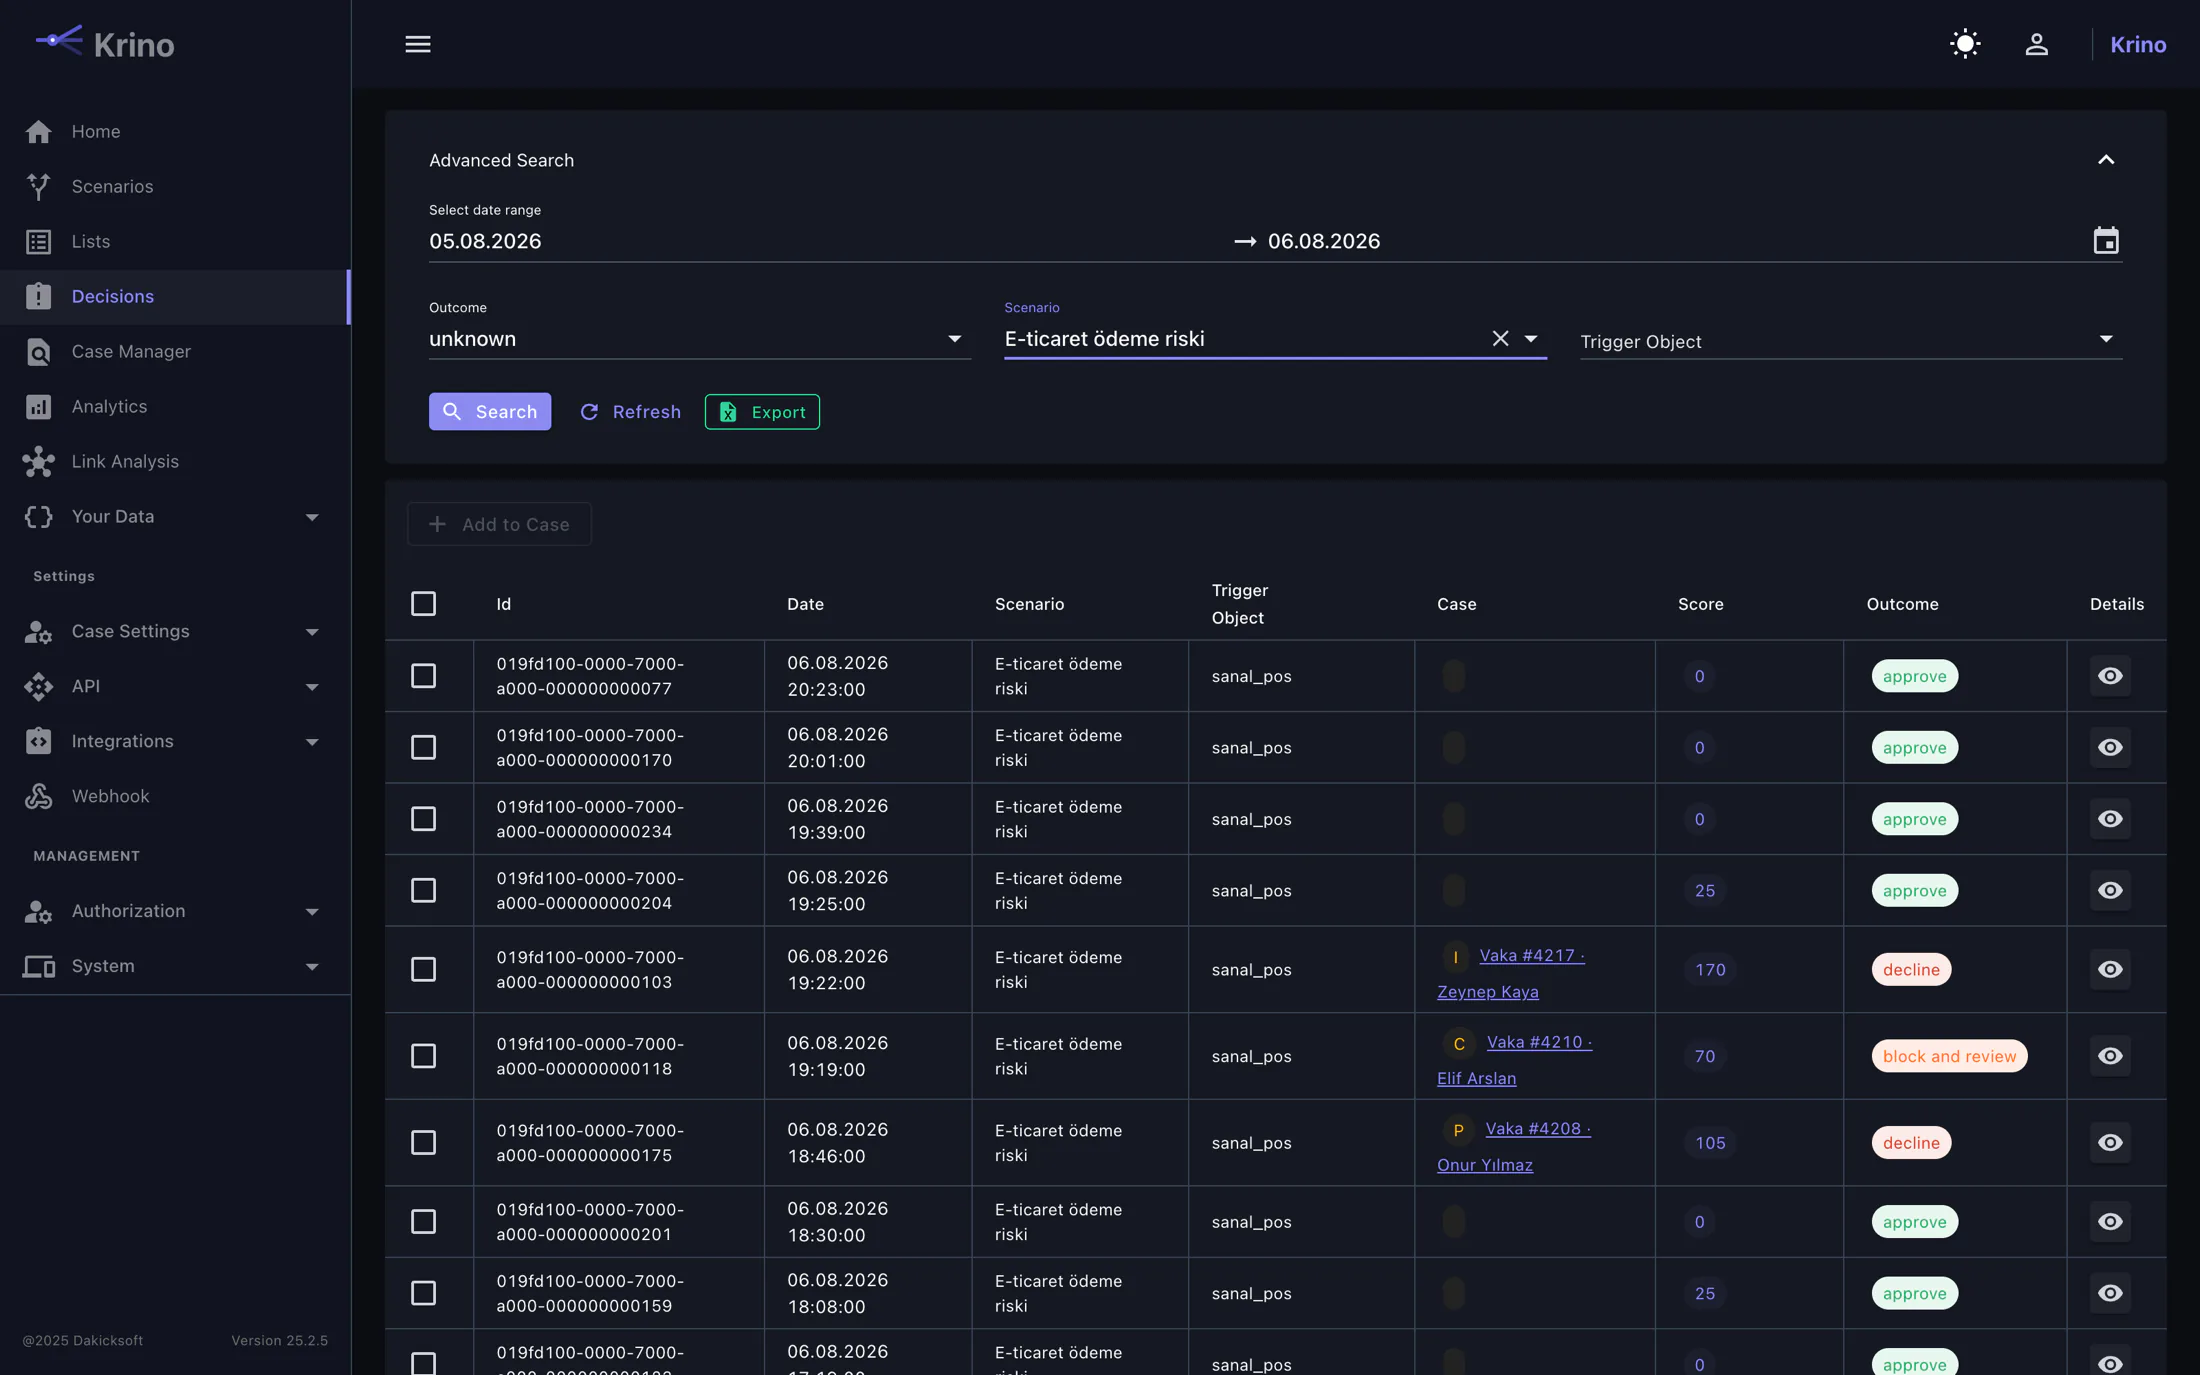
Да. Отдельный экран показывает решения потоком, по мере их записи: исход, балл, сценарий, клиент и открытый кейс, если он был. Первая минута после публикации скажет вам сейчас то, что дашборд скажет через полчаса.
Это выборка, а не источник истины: если в загруженную минуту решений окажется больше, чем экран способен показать, он прямо об этом скажет, а за полным списком вы пойдёте в поиск по решениям.
Это выборка, а не источник истины: если в загруженную минуту решений окажется больше, чем экран способен показать, он прямо об этом скажет, а за полным списком вы пойдёте в поиск по решениям.
Как работа распределяется по команде?
Кейсы попадают в очереди и назначаются автоматически тому, у кого в этой очереди меньше всего открытых дел. Кейс можно отложить до будущей даты; в нужный день он вернётся в очередь сам. О назначении, о приближении срока и о его нарушении аналитик получает уведомление. А сорок кейсов с одинаковым исходом не нужно открывать по одному: отметьте их в списке и закройте, назначьте или промаркируйте одним шагом — правило второго согласования по-прежнему проверяется по каждому кейсу, а о том, что применить не удалось, сообщается с причиной.
Цена и договор.
Сколько это стоит?
Один тариф, все модули включены, без платы за транзакцию. Лицензию для работы на ваших серверах мы рассчитываем под вашу организацию, со скидкой при оплате года вперёд. Запросите расчёт на странице цен.
Цена растёт с объёмом?
Нет. Лицензия фиксированная и не зависит от числа транзакций, решений и пользователей. Растут только ваши собственные расходы на серверы.
Можно попробовать до покупки?
Да. Пришлите анонимизированную выборку; мы развернём оценочный контур, прогоним ваши правила и положим результаты рядом с вашим текущим процессом.
Можно ли посмотреть исходный код?
В корпоративных оценках мы идём навстречу запросам на аудит кода. Давайте обсудим объём.
Не нашли ответ?
Напишите напрямую — на один и тот же адрес приходят и технические, и коммерческие вопросы.